RPC 基本原理
📦 本文已归档到:「blog」
1. 缓存概述
1.1. 什么是缓存
缓存就是数据交换的缓冲区。
缓存是用于存储数据的硬件或软件的组成部分,以使得后续更快访问相应的数据。缓存中的数据可能是提前计算好的结果、数据的副本等。典型的应用场景:有 cpu cache, 磁盘 cache 等。本文中提及到缓存主要是指互联网应用中所使用的缓存组件。
1.2. 为什么引入缓存
传统的后端业务场景中,访问量以及对响应时间的要求均不高,通常只使用数据库即可满足要求。这种架构简单,便于快速部署,很多网站发展初期均考虑使用这种架构。但是随着访问量的上升,以及对响应时间的要求提升,一个数据库服务已无法再满足要求。这时候通常会考虑数据库拆分(sharding)、读写分离、甚至硬件升级(SSD)等以满足新的业务需求。但是这种方式仍然会面临很多问题,主要体现在:
- 性能提升有限,很难达到数量级上的提升,尤其在互联网业务场景下,随着网站的发展,访问量经常会面临十倍、百倍的上涨。
- 成本高昂,为了承载 N 倍的访问量,通常需要 N 倍的机器,这个代价难以接受。
在数据层引入缓存,有以下几个好处:
- 提升数据读取速度。
- 提升系统扩展能力,通过扩展缓存,提升系统承载能力。
- 降低存储成本,Cache+DB 的方式可以承担原有需要多台 DB 才能承担的请求量,节省机器成本。
根据业务场景,通常缓存有以下几种使用方式:
- 懒汉式(读时触发):写入 DB 后, 然后把相关的数据也写入 Cache。
- 饥饿式(写时触发):先查询 DB 里的数据, 然后把相关的数据写入 Cache。
- 定期刷新:适合周期性的跑数据的任务,或者列表型的数据,而且不要求绝对实时性。
1.3. 缓存的基本原理
- 将数据写入/读取速度更快的存储(设备);
- 将数据缓存到离应用最近的位置;
- 将数据缓存到离用户最近的位置。
1.4. 缓存淘汰算法
常见的缓存淘汰算法有以下几种:
- FIFO - 先进先出,在这种淘汰算法中,先进入缓存的会先被淘汰。这种可谓是最简单的了,但是会导致我们命中率很低。试想一下我们如果有个访问频率很高的数据是所有数据第一个访问的,而那些不是很高的是后面再访问的,那这样就会把我们的首个数据但是他的访问频率很高给挤出。
- LRU - 最近最少使用算法。在这种算法中避免了上面的问题,每次访问数据都会将其放在我们的队尾,如果需要淘汰数据,就只需要淘汰队首即可。但是这个依然有个问题,如果有个数据在 1 个小时的前 59 分钟访问了 1 万次(可见这是个热点数据),再后一分钟没有访问这个数据,但是有其他的数据访问,就导致了我们这个热点数据被淘汰。
- LFU - 最近最少频率使用。在这种算法中又对上面进行了优化,利用额外的空间记录每个数据的使用频率,然后选出频率最低进行淘汰。这样就避免了 LRU 不能处理时间段的问题。
这三种缓存淘汰算法,实现复杂度一个比一个高,同样的命中率也是一个比一个好。而我们一般来说选择的方案居中即可,即实现成本不是太高,而命中率也还行的 LRU。
1.5. 缓存的分类
在分布式系统中,缓存的应用非常广泛,从部署角度有以下几个方面的缓存应用。
- CDN 缓存 - 存放 HTML、CSS、JS 等静态资源。
- 反向代理缓存 - 动静分离,只缓存用户请求的静态资源。
- 进程内缓存 - 缓存应用字典等常用数据。
- 分布式缓存 - 缓存数据库中的热点数据。
1.6. 缓存整体架构
通常,网站的缓存整体架构如下图所示:

- 浏览器向客户端发起请求,如果 CDN 有缓存则直接返回;
- 如果 CDN 无缓存,则访问反向代理服务器;
- 如果反向代理服务器有缓存则直接返回;
- 如果反向代理服务器无缓存或动态请求,则访问应用服务器;
- 应用服务器访问进程内缓存;如果有缓存,则返回代理服务器,并缓存数据;(动态请求不缓存)
- 如果进程内缓存无数据,则读取分布式缓存;并返回应用服务器;应用服务器将数据缓存到本地缓存(部分);
- 如果分布式缓存无数据,则应用程序读取数据库数据,并放入分布式缓存;
2. CDN 缓存
CDN 将数据缓存到离用户物理距离最近的服务器,使得用户可以就近获取请求内容。CDN 一般缓存静态资源文件(页面,脚本,图片,视频,文件等)。
国内网络异常复杂,跨运营商的网络访问会很慢。为了解决跨运营商或各地用户访问问题,可以在重要的城市,部署 CDN 应用。使用户就近获取所需内容,降低网络拥塞,提高用户访问响应速度和命中率。
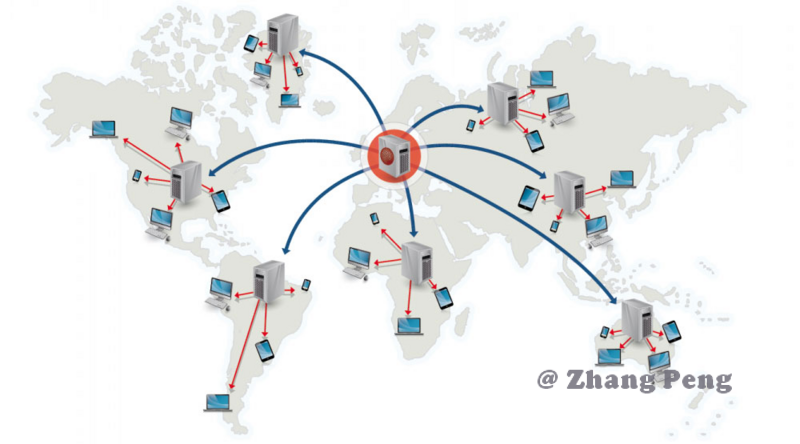
CDN 的基本原理是广泛采用各种缓存服务器,将这些缓存服务器分布到用户访问相对集中的地区或网络中,在用户访问网站时,利用全局负载技术将用户的访问指向距离最近的工作正常的缓存服务器上,由缓存服务器直接响应用户请求。
(1)未部署 CDN 应用前的网络路径:
- 请求:本机网络(局域网)=> 运营商网络 => 应用服务器机房
- 响应:应用服务器机房 => 运营商网络 => 本机网络(局域网)
在不考虑复杂网络的情况下,从请求到响应需要经过 3 个节点,6 个步骤完成一次用户访问操作。
(2)部署 CDN 应用后网络路径:
- 请求:本机网络(局域网) => 运营商网络
- 响应:运营商网络 => 本机网络(局域网)
在不考虑复杂网络的情况下,从请求到响应需要经过 2 个节点,2 个步骤完成一次用户访问操作。
与不部署 CDN 服务相比,减少了 1 个节点,4 个步骤的访问。极大的提高的系统的响应速度。
2.2. CDN 特点
- 优点
- 本地 Cache 加速 - 提升访问速度,尤其含有大量图片和静态页面站点;
- 镜像服务 - 消除了不同运营商之间互联的瓶颈造成的影响,实现了跨运营商的网络加速,保证不同网络中的用户都能得到良好的访问质量;
- 远程加速 - 远程访问用户根据 DNS 负载均衡技术智能自动选择 Cache 服务器,选择最快的 Cache 服务器,加快远程访问的速度;
- 带宽优化 - 自动生成服务器的远程 Mirror(镜像)cache 服务器,远程用户访问时从 cache 服务器上读取数据,减少远程访问的带宽、分担网络流量、减轻原站点 WEB 服务器负载等功能。
- 集群抗攻击 - 广泛分布的 CDN 节点加上节点之间的智能冗余机制,可以有效地预防黑客入侵以及降低各种 D.D.o.S 攻击对网站的影响,同时保证较好的服务质量。
- 缺点
- 不适宜缓存动态资源
- 解决方案:主要缓存静态资源,动态资源建立多级缓存或准实时同步;
- 存在数据的一致性问题
- 解决方案(主要是在性能和数据一致性二者间寻找一个平衡)
- 设置缓存失效时间(1 个小时,过期后同步数据)。
- 针对资源设置版本号。
- 解决方案(主要是在性能和数据一致性二者间寻找一个平衡)
- 不适宜缓存动态资源
3. 反向代理缓存
反向代理(Reverse Proxy)方式是指以代理服务器来接受 internet 上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给 internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。
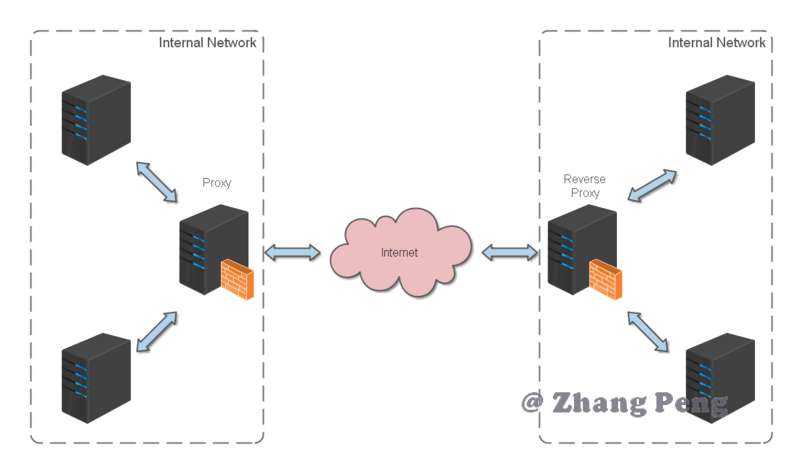
反向代理位于应用服务器同一网络,处理所有对 WEB 服务器的请求。
反向代理缓存的原理:
- 如果用户请求的页面在代理服务器上有缓存的话,代理服务器直接将缓存内容发送给用户。
- 如果没有缓存则先向 WEB 服务器发出请求,取回数据,本地缓存后再发送给用户。
这种方式通过降低向 WEB 服务器的请求数,从而降低了 WEB 服务器的负载。
反向代理缓存一般针对的是静态资源,而将动态资源请求转发到应用服务器处理。常用的缓存应用服务器有 Varnish,Ngnix,Squid。
3.2. 代理缓存比较
常用的代理缓存有 Varnish,Squid,Ngnix,简单比较如下:
- Varnish 和 Squid 是专业的 cache 服务,Ngnix 需要第三方模块支持;
- Varnish 采用内存型缓存,避免了频繁在内存、磁盘中交换文件,性能比 Squid 高;
- Varnish 由于是内存 cache,所以对小文件如 css、js、小图片的支持很棒,后端的持久化缓存可以采用的是 Squid 或 ATS;
- Squid 功能全而大,适合于各种静态的文件缓存,一般会在前端挂一个 HAProxy 或 Ngnix 做负载均衡跑多个实例;
- Nginx 采用第三方模块 ncache 做的缓冲,性能基本达到 Varnish,一般作为反向代理使用,可以实现简单的缓存。
4. 进程内缓存
进程内缓存是指应用内部的缓存,标准的分布式系统,一般有多级缓存构成。本地缓存是离应用最近的缓存,一般可以将数据缓存到硬盘或内存。
硬盘缓存- 将数据缓存到硬盘到,读取时从硬盘读取。原理是直接读取本机文件,减少了网络传输消耗,比通过网络读取数据库速度更快。可以应用在对速度要求不是很高,但需要大量缓存存储的场景。内存缓存- 直接将数据存储到本机内存中,通过程序直接维护缓存对象,是访问速度最快的方式。
常见的本地缓存实现方案:HashMap、Guava Cache、Caffeine、Ehcache。
4.1. ConcurrentHashMap
最简单的进程内缓存可以通过 JDK 自带的 HashMap 或 ConcurrentHashMap 实现。
适用场景:不需要淘汰的缓存数据。
缺点:无法进行缓存淘汰,内存会无限制的增长。
4.2. LRUHashMap
可以通过继承 LinkedHashMap 来实现一个简单的 LRUHashMap。重写 removeEldestEntry 方法,即可完成一个简单的最近最少使用算法。
- 缺点:
- 锁竞争严重,性能比较低。
- 不支持过期时间
- 不支持自动刷新
4.3. Guava Cache
解决了 LRUHashMap 中的几个缺点。
Guava Cache 采用了类似 ConcurrentHashMap 的思想,分段加锁,减少锁竞争。
Guava Cache 对于过期的 Entry 并没有马上过期(也就是并没有后台线程一直在扫),而是通过进行读写操作的时候进行过期处理,这样做的好处是避免后台线程扫描的时候进行全局加锁。
直接通过查询,判断其是否满足刷新条件,进行刷新。
4.4. Caffeine
Caffeine 实现了 W-TinyLFU(LFU+LRU 算法的变种),其命中率和读写吞吐量大大优于 Guava Cache。
其实现原理较复杂,可以参考你应该知道的缓存进化史。
4.5. 选择进程内缓存
| 比较项 | ConcurrentHashMap | LRUMap | Ehcache | Guava Cache | Caffeine |
|---|---|---|---|---|---|
| 读写性能 | 很好,分段锁 | 一般,全局加锁 | 好 | 好,需要做淘汰操作 | 很好 |
| 淘汰算法 | 无 | LRU,一般 | 支持多种淘汰算法,LRU,LFU,FIFO | LRU,一般 | W-TinyLFU, 很好 |
| 功能丰富程度 | 功能比较简单 | 功能比较单一 | 功能很丰富 | 功能很丰富,支持刷新和虚引用等 | 功能和 Guava Cache 类似 |
| 工具大小 | jdk 自带类,很小 | 基于 LinkedHashMap,较小 | 很大,最新版本 1.4MB | 是 Guava 工具类中的一个小部分,较小 | 一般,最新版本 644KB |
| 是否持久化 | 否 | 否 | 是 | 否 | 否 |
| 是否支持集群 | 否 | 否 | 是 | 否 | 否 |
ConcurrentHashMap- 比较适合缓存比较固定不变的元素,且缓存的数量较小的。虽然从上面表格中比起来有点逊色,但是其由于是 JDK 自带的类,在各种框架中依然有大量的使用,比如我们可以用来缓存我们反射的 Method,Field 等等;也可以缓存一些链接,防止其重复建立。在 Caffeine 中也是使用的ConcurrentHashMap来存储元素。LRUMap- 如果不想引入第三方包,又想使用淘汰算法淘汰数据,可以使用这个。Ehcache- 由于其 jar 包很大,较重量级。对于需要持久化和集群的一些功能的,可以选择 Ehcache。笔者没怎么使用过这个缓存,如果要选择的话,可以选择分布式缓存来替代 Ehcache。Guava Cache- Guava 这个 jar 包在很多 Java 应用程序中都有大量的引入,所以很多时候其实是直接用就好了,并且其本身是轻量级的而且功能较为丰富,在不了解 Caffeine 的情况下可以选择 Guava Cache。Caffeine- 其在命中率,读写性能上都比 Guava Cache 好很多,并且其 API 和 Guava cache 基本一致,甚至会多一点。在真实环境中使用 Caffeine,取得过不错的效果。
总结一下:如果不需要淘汰算法则选择 ConcurrentHashMap,如果需要淘汰算法和一些丰富的 API,推荐选择 Caffeine。
5. 分布式缓存
分布式缓存解决了进程内缓存最大的问题:如果应用是分布式系统,节点之间无法共享彼此的进程内缓存。
分布式缓存的应用场景:
- 缓存经过复杂计算得到的数据
- 缓存系统中频繁访问的热点数据,减轻数据库压力
不同分布式缓存的实现原理往往有比较大的差异。本文主要针对 Memcached 和 Redis 进行说明。
5.1. Memcache
Memcache 是一个高性能,分布式内存对象缓存系统,通过在内存里维护一个统一的巨大的 hash 表,它能够用来存储各种格式的数据,包括图像、视频、文件以及数据库检索的结果等。
简单的说就是:将数据缓存到内存中,然后从内存中读取,从而大大提高读取速度。
Memcache 特性
- 使用物理内存作为缓存区,可独立运行在服务器上。每个进程最大 2G,如果想缓存更多的数据,可以开辟更多的 Memcache 进程(不同端口)或者使用分布式 Memcache 进行缓存,将数据缓存到不同的物理机或者虚拟机上。
- 使用 key-value 的方式来存储数据。这是一种单索引的结构化数据组织形式,可使数据项查询时间复杂度为 O(1)。
- 协议简单,基于文本行的协议。直接通过 telnet 在 Memcached 服务器上可进行存取数据操作,简单,方便多种缓存参考此协议;
- 基于 libevent 高性能通信。Libevent 是一套利用 C 开发的程序库,它将 BSD 系统的 kqueue,Linux 系统的 epoll 等事件处理功能封装成一个接口,与传统的 select 相比,提高了性能。
- 分布式能力取决于 Memcache 客户端,服务器之间互不通信。各个 Memcached 服务器之间互不通信,各自独立存取数据,不共享任何信息。服务器并不具有分布式功能,分布式部署取决于 Memcached 客户端。
- 采用 LRU 缓存淘汰策略。在 Memcached 内存储数据项时,可以指定它在缓存的失效时间,默认为永久。当 Memcached 服务器用完分配的内时,失效的数据被首先替换,然后也是最近未使用的数据。在 LRU 中,Memcached 使用的是一种 Lazy Expiration 策略,自己不会监控存入的 key/vlue 对是否过期,而是在获取 key 值时查看记录的时间戳,检查 key/value 对空间是否过期,这样可减轻服务器的负载。
- 内置了一套高效的内存管理算法。这套内存管理效率很高,而且不会造成内存碎片,但是它最大的缺点就是会导致空间浪费。当内存满后,通过 LRU 算法自动删除不使用的缓存。
- 不支持持久化。Memcached 没有考虑数据的容灾问题,重启服务,所有数据会丢失。
Memcache 工作原理
(1)内存管理
Memcached 利用 slab allocation 机制来分配和管理内存,它按照预先规定的大小,将分配的内存分割成特定长度的内存块,再把尺寸相同的内存块分成组,数据在存放时,根据键值 大小去匹配 slab 大小,找就近的 slab 存放,所以存在空间浪费现象。
这套内存管理效率很高,而且不会造成内存碎片,但是它最大的缺点就是会导致空间浪费。
(2)缓存淘汰策略
Memcached 的缓存淘汰策略是 LRU + 到期失效策略。
当你在 Memcached 内存储数据项时,你有可能会指定它在缓存的失效时间,默认为永久。当 Memcached 服务器用完分配的内时,失效的数据被首先替换,然后是最近未使用的数据。
在 LRU 中,Memcached 使用的是一种 Lazy Expiration 策略:Memcached 不会监控存入的 key/vlue 对是否过期,而是在获取 key 值时查看记录的时间戳,检查 key/value 对空间是否过期,这样可减轻服务器的负载。
(3)分区
Memcached 服务器之间彼此不通信,它的分布式能力是依赖客户端来实现。
具体来说,就是在客户端实现一种算法,根据 key 来计算出数据应该向哪个服务器节点读/写。
而这种选取集群节点的算法常见的有三种:
- 哈希取余算法 - 使用公式:
hash(key)% N计算出 哈希值 来决定数据映射到哪一个节点。 - 一致性哈希算法 - 可以很好的解决 稳定性问题,可以将所有的 存储节点 排列在 首尾相接 的
Hash环上,每个key在计算Hash后会 顺时针 找到 临接 的 存储节点 存放。而当有节点 加入 或 退出 时,仅影响该节点在Hash环上 顺时针相邻 的 后续节点。 - 虚拟 Hash 槽算法 - 使用 分散度良好 的 哈希函数 把所有数据 映射 到一个 固定范围 的 整数集合 中,整数定义为 槽(
slot),这个范围一般 远远大于 节点数。槽 是集群内 数据管理 和 迁移 的 基本单位。采用 大范围槽 的主要目的是为了方便 数据拆分 和 集群扩展。每个节点会负责 一定数量的槽。
5.2. Redis
Redis 是一个开源(BSD 许可)的,基于内存的,多数据结构存储系统。可以用作数据库、缓存和消息中间件。
Redis 还可以使用客户端分片来扩展写性能。内置了 复制(replication),LUA 脚本(Lua scripting),LRU 驱动事件(LRU eviction),事务(transactions) 和不同级别的 磁盘持久化(persistence), 并通过 Redis 哨兵(Sentinel)和自动分区(Cluster)提供高可用性(high availability)。
Redis 特性
支持多种数据类型 - string、hash、list、set、sorted set。
支持多种数据淘汰策略
- volatile-lru - 从已设置过期时间的数据集中挑选最近最少使用的数据淘汰
- volatile-ttl - 从已设置过期时间的数据集中挑选将要过期的数据淘汰
- volatile-random - 从已设置过期时间的数据集中任意选择数据淘汰
- allkeys-lru - 从所有数据集中挑选最近最少使用的数据淘汰
- allkeys-random - 从所有数据集中任意选择数据进行淘汰
- noeviction - 禁止驱逐数据
提供两种持久化方式 - RDB 和 AOF
通过 Redis cluster 提供集群模式。
Redis 原理
- 缓存淘汰
- Redis 有两种数据淘汰实现
- 消极方式 - 访问 Redis key 时,如果发现它已经失效,则删除它
- 积极方式 - 周期性从设置了失效时间的 key 中,根据淘汰策略,选择一部分失效的 key 进行删除。
- Redis 有两种数据淘汰实现
- 分区
- Redis Cluster 集群包含 16384 个虚拟 Hash 槽,它通过一个高效的算法来计算 key 属于哪个 Hash 槽。
- Redis Cluster 支持请求分发 - 节点在接到一个命令请求时,会先检测这个命令请求要处理的键所在的槽是否由自己负责,如果不是的话,节点将向客户端返回一个 MOVED 错误,MOVED 错误携带的信息可以指引客户端将请求重定向至正在负责相关槽的节点。
- 主从复制
- Redis 2.8 后支持异步复制。它有两种模式:
完整重同步(full resychronization)- 用于初次复制。执行步骤与SYNC命令基本一致。部分重同步(partial resychronization)- 用于断线后重复制。如果条件允许,主服务器可以将主从服务器连接断开期间执行的写命令发送给从服务器,从服务器只需接收并执行这些写命令,即可将主从服务器的数据库状态保持一致。
- 集群中每个节点都会定期向集群中的其他节点发送 PING 消息,以此来检测对方是否在线。
- 如果一个主节点被认为下线,则在其从节点中,根据 Raft 算法,选举出一个节点,升级为主节点。
- Redis 2.8 后支持异步复制。它有两种模式:
- 数据一致性
- Redis 不保证强一致性,因为这会使得集群性能大大降低。
- Redis 是通过异步复制来实现最终一致性。
5.3. 选择分布式缓存
不同的分布式缓存功能特性和实现原理方面有很大的差异,因此他们所适应的场景也有所不同。
这里选取三个比较出名的分布式缓存(MemCache,Redis,Tair)来作为比较:
| 比较项 | MemCache | Redis | Tair |
|---|---|---|---|
| 数据结构 | 只支持简单的 Key-Value 结构 | String,Hash, List, Set, Sorted Set | String,HashMap, List,Set |
| 持久化 | 不支持 | 支持 | 支持 |
| 容量大小 | 数据纯内存,数据存储不宜过多 | 数据全内存,资源成本考量不宜超过 100GB | 可以配置全内存或内存+磁盘引擎,数据容量可无限扩充 |
| 读写性能 | 很高 | 很高(RT0.5ms 左右) | String 类型比较高(RT1ms 左右),复杂类型比较慢(RT5ms 左右) |
| 过期策略 | 过期后,不删除缓存 | 有六种策略来处理过期数据 | 支持 |
MemCache- 这一块接触得比较少,不做过多的推荐。其吞吐量较大,但是支持的数据结构较少,并且不支持持久化。Redis- 支持丰富的数据结构,读写性能很高,但是数据全内存,必须要考虑资源成本,支持持久化。Tair- 支持丰富的数据结构,读写性能较高,部分类型比较慢,理论上容量可以无限扩充。
总结:如果服务对延迟比较敏感,Map/Set 数据也比较多的话,比较适合 Redis。如果服务需要放入缓存量的数据很大,对延迟又不是特别敏感的话,那就可以选择 Tair。
6. 多级缓存
6.1. 使用进程内缓存
如果应用服务不是分布式系统,那么进程内缓存当然是缓存的首选方案。
对于进程内缓存,其本来受限于内存的大小的限制,以及进程缓存更新后其他缓存无法得知,所以一般来说进程缓存适用于:
- 数据量不是很大且更新频率较低的数据。
- 如果更新频繁的数据,也想使用进程内缓存,那么可以将其过期时间设置为较短的时间,或者设置较短的自动刷新时间。
这种方案存在以下问题:
- 如果应用服务是分布式系统,应用节点之间无法共享缓存,存在数据不一致问题。
- 由于进程内缓存受限于内存大小的限制,所以缓存不能无限扩展。
6.2. 使用分布式缓存
如果应用服务是分布式系统,那么最简单的缓存方案就是直接使用分布式缓存。
其应用场景如图所示:
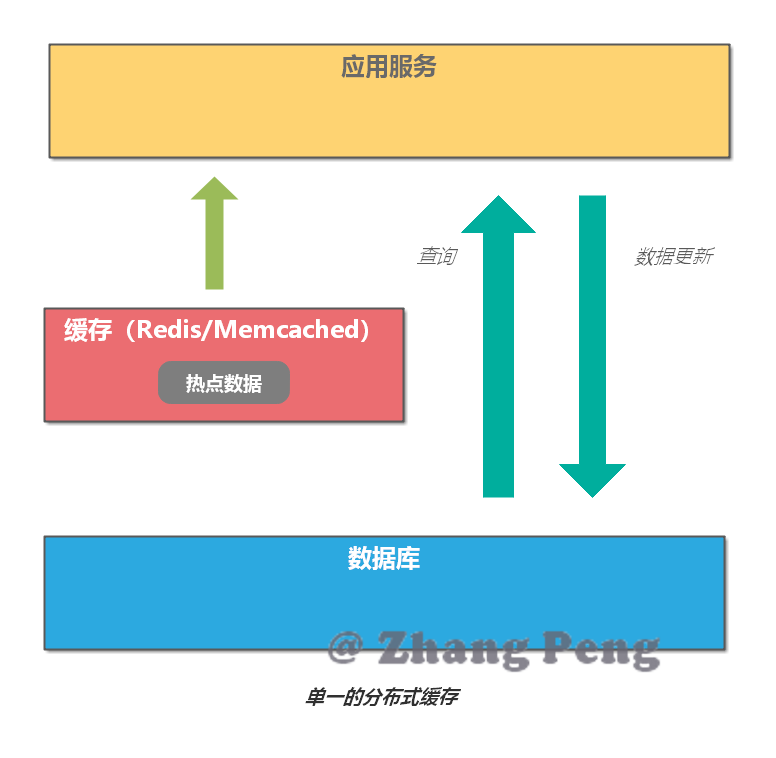
这种方案存在以下问题:
- 缓存服务如果挂了,这时应用只能访问数据库,容易造成缓存雪崩。
- 访问分布式缓存服务会有一定的 I/O 以及序列化反序列化的开销,虽然性能很高,但是其终究没有在内存中查询快。
6.3. 使用多级缓存
单纯使用进程内缓存和分布式缓存都存在各自的不足。如果需要更高的性能以及更好的可用性,我们可以将缓存设计为多级结构。将最热的数据使用进程内缓存存储在内存中,进一步提升访问速度。
这个设计思路在计算机系统中也存在,比如 CPU 使用 L1、L2、L3 多级缓存,用来减少对内存的直接访问,从而加快访问速度。
一般来说,多级缓存架构使用二级缓存已可以满足大部分业务需求,过多的分级会增加系统的复杂度以及维护的成本。因此,多级缓存不是分级越多越好,需要根据实际情况进行权衡。
一个典型的二级缓存架构,可以使用进程内缓存(如: Caffeine/Google Guava/Ehcache/HashMap)作为一级缓存;使用分布式缓存(如:Redis/Memcached)作为二级缓存。
多级缓存查询
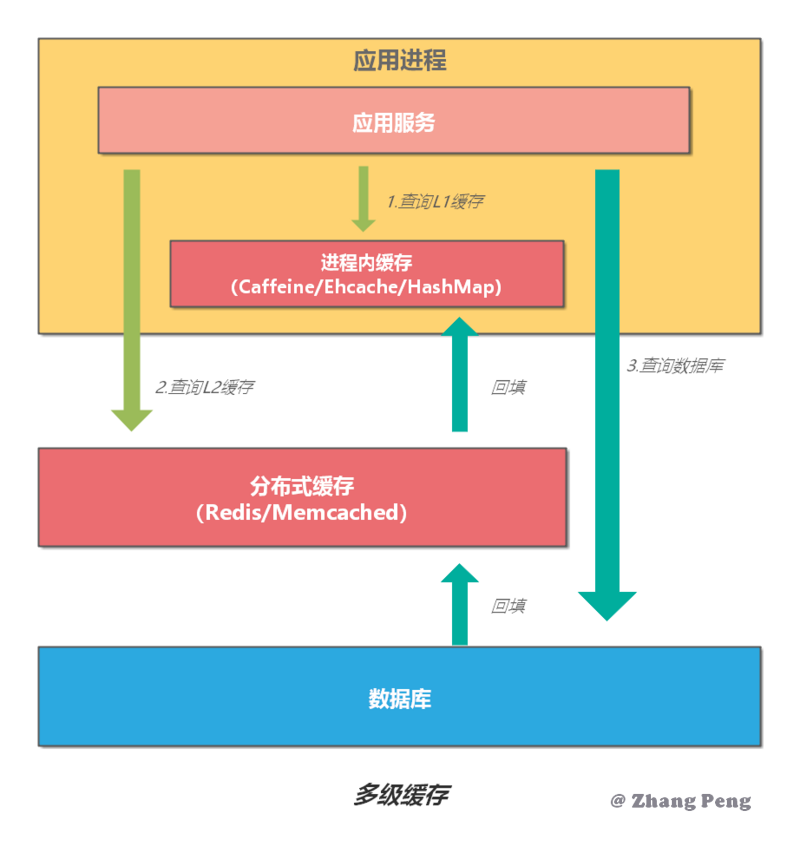
- 首先,查询 L1 缓存,如果缓存命中,直接返回结果;如果没有命中,执行下一步。
- 接下来,查询 L2 缓存,如果缓存命中,直接返回结果并回填 L1 缓存;如果没有命中,执行下一步。
- 最后,查询数据库,返回结果并依次回填 L2 缓存、L1 缓存。
多级缓存更新
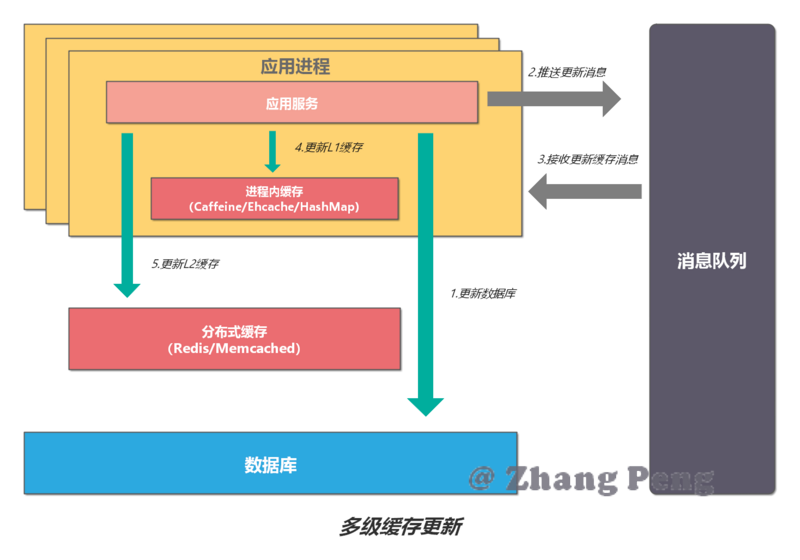
对于 L1 缓存,如果有数据更新,只能删除并更新所在机器上的缓存,其他机器只能通过超时机制来刷新缓存。超时设定可以有两种策略:
- 设置成写入后多少时间后过期
- 设置成写入后多少时间刷新
对于 L1 缓存,如果有数据更新,其他机器立马可见。但是,也必须要设置超时时间,其时间应该比 L1 缓存的有效时间长。
为了解决进程内缓存不一致的问题,设计可以进一步优化:
7. 缓存问题
7.1. 缓存雪崩
缓存雪崩是指缓存不可用或者大量缓存由于超时时间相同在同一时间段失效,大量请求直接访问数据库,数据库压力过大导致系统雪崩。
解决方案:
- 增加缓存系统可用性。通过监控关注缓存的健康程度,根据业务量适当的扩容缓存。
- 采用多级缓存。不同级别缓存设置的超时时间不同,即使某个级别缓存都过期,也有其他级别缓存兜底。
- 缓存的过期时间可以取个随机值。比如以前是设置 10 分钟的超时时间,那每个 Key 都可以随机 8-13 分钟过期,尽量让不同 Key 的过期时间不同。
- 对数据库进行过载保护或应用层限流。
7.2. 缓存穿透
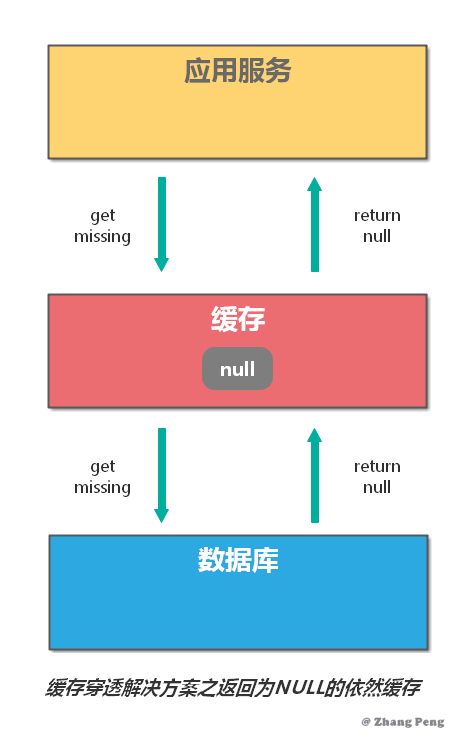
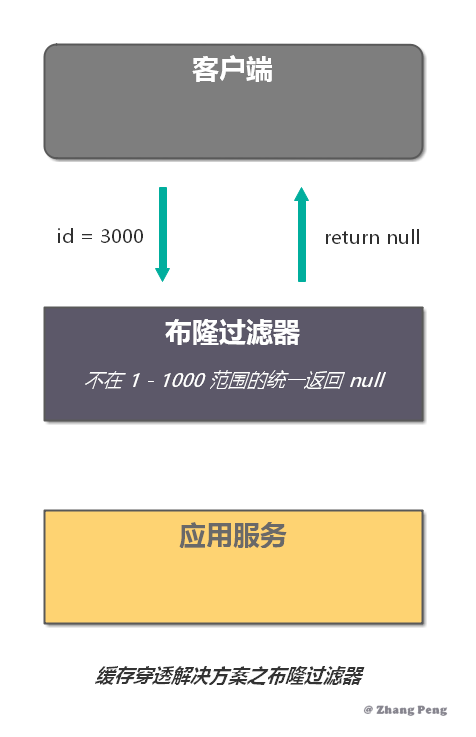
缓存穿透是指:查询的数据在数据库中不存在,那么缓存中自然也不存在。所以,应用在缓存中查不到,则会去查询数据库。当这样的请求多了后,数据库的压力就会增大。
解决缓存穿透,一般有两种方法:
- 对于返回为 NULL 的依然缓存,对于抛出异常的返回不进行缓存。
- 过滤不可能存在的数据
7.3. 缓存击穿
对于某些 key 设置了过期时间,但是其是热点数据,如果某个 key 失效,可能大量的请求打过来,缓存未命中,然后去数据库访问,此时数据库访问量会急剧增加。
为了避免这个问题,我们可以采取下面的两个手段:
- 分布式锁 - 锁住热点数据的 key,避免大量线程同时访问同一个 key。
- 异步加载 - 可以对部分数据采取到期自动刷新的策略,而不是到期自动淘汰。淘汰其实也是为了数据的时效性,所以采用自动刷新也可以。
7.4. 缓存更新
一般来说缓存的更新有两种情况:
- 先删除缓存,再更新数据库。
- 先更新数据库,再删除缓存。
为什么是删除缓存,而不是更新缓存呢?
你可以想想当有多个并发的请求更新数据,你并不能保证更新数据库的顺序和更新缓存的顺序一致,那就会出现数据库中和缓存中数据不一致的情况。所以一般来说考虑删除缓存。
- 先删除缓存,再更新数据库
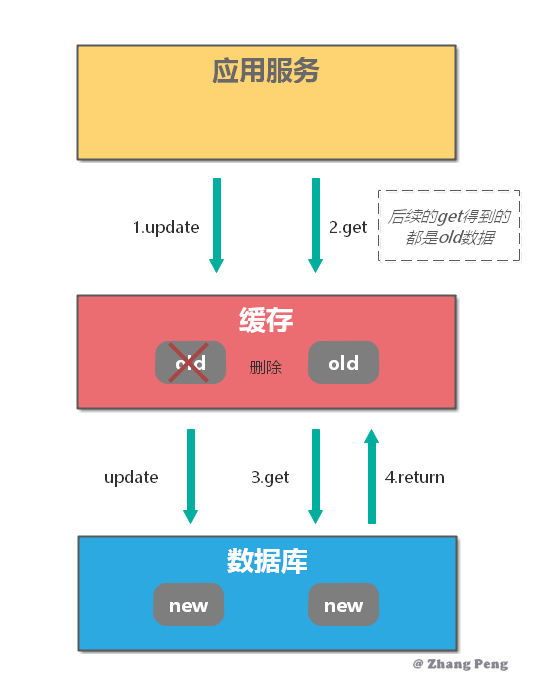
对于一个更新操作简单来说,就是先去各级缓存进行删除,然后更新数据库。
这个操作有一个比较大的问题,在对缓存删除完之后,有一个读请求,这个时候由于缓存被删除所以直接会读库,读操作的数据是老的并且会被加载进入缓存当中,后续读请求全部访问的老数据。
先删除缓存也有一个好处是,如果对数据库操作失败了,那么由于先删除的缓存,最多只是造成 Cache Miss。
- 先更新数据库,再删除缓存
注:更推荐使用这种策略
如果我们使用更新数据库,再删除缓存就能避免上面的问题。
但是同样的引入了新的问题:假设执行更新操作时,又接收到查询请求,此时就会返回缓存中的老数据。更麻烦的是,如果数据库更新操作执行失败,则缓存中可能永远是脏数据。
- 应该选择哪种更新测录
通过上面的内容,我们知道,两种更新策略都存在并发问题。
但是建议选择先更新数据库,再删除缓存,因为其并发问题出现的概率可能非常低,因为这个条件需要发生在读缓存时缓存失效,而且并发着有一个写操作。而实际上数据库的写操作会比读操作慢得多,而且还要锁表,而读操作必需在写操作前进入数据库操作,而又要晚于写操作更新缓存,所有的这些条件都具备的概率基本并不大。
如果需要数据库和缓存保证强一致性,则可以通过 2PC 或 Paxos 协议来实现。但是 2PC 太慢,而 Paxos 太复杂,所以如果不是非常重要的数据,不建议使用强一致性方案。
7.5. 缓存预热
缓存预热是指系统启动后,将常用的数据直接缓存。这样就可以避免用户请求的时候,先查询数据库,然后再更新缓存的问题。
解决方案:
- 直接写个缓存刷新页面,上线时手工操作下。
- 数据量不大,可以在项目启动的时候自动进行加载。
- 定时刷新缓存。
7.6. 缓存降级
当访问量剧增、服务出现问题(如响应时间慢或不响应)或非核心服务影响到核心流程的性能时,仍然需要保证服务还是可用的,即使是有损服务。系统可以根据一些关键数据进行自动降级,也可以配置开关实现人工降级。
降级的最终目的是保证核心服务可用,即使是有损的。而且有些服务是无法降级的(如加入购物车、结算)。